rpc服务和高性能bff层
GitHub:https://github.com/fengnovo/rpc-bff
基于grpc的rpc服务实现
grpcdemo目录
基于nodejs的高性能bff层
bff目录
sofa-rpc-node
参考 https://www.wenjiangs.com/doc/dqoczbsk
rpc-bff 项目分析
这个项目是一个 Node.js 的 BFF + RPC 微服务示例,主线在 bff/,另有一个独立的 grpcdemo/ 用来演示 gRPC 的 proto 契约和客户端/服务端调用。
rpc服务聚合 先安装zookeeper 用 sofa-rpc-node连接
多级缓存 LRU redis
消息队列 先安装RabbitMQ,用amqplib连接
1. 总体架构
核心思想:
- BFF 层:
bff/bff/index.js对外提供 HTTP 接口GET /?userId=1,把前端需要的用户信息和文章数量聚合成一个响应。 - RPC 微服务:
bff/user/index.js提供com.keen.user.getUserInfo,bff/post/index.js提供com.keen.post.getPostCount。 - 注册中心:两个 RPC 服务启动后把服务信息发布到 Zookeeper,BFF 通过 Zookeeper 发现服务。
- 数据库:user/post 服务都连接 MySQL 的
bff数据库。 - 缓存:BFF 设计了 LRU 本地缓存 + Redis 二级缓存。
- 消息队列:BFF 把访问日志投递到 RabbitMQ,
bff/write-logger/index.js独立消费并写入logger.txt。 - gRPC demo:
grpcdemo/不参与 BFF 主链路,只是展示另一种 RPC 协议的基础用法。
2. HTTP 请求聚合流程
一次 GET /?userId=1 的执行顺序:
- Koa 按
app.use注册顺序执行中间件:koa-logger、rpcMiddleware、cacheMiddleware、mqMiddleware。 rpcMiddleware为com.keen.user和com.keen.post创建 RPC consumer,并挂到ctx.rpcConsumers。cacheMiddleware创建缓存门面ctx.cache。mqMiddleware连接 RabbitMQ,创建loggerchannel,并挂到ctx.channels.logger。- 路由先发送日志消息到 RabbitMQ 的
logger队列。 - 路由生成缓存 key:
${method}-${path}-${userId},例如GET-/-1。 - 如果缓存命中,直接返回缓存对象。
- 如果缓存未命中,BFF 使用
Promise.all并发调用:user.invoke('getUserInfo', [userId])post.invoke('getPostCount', [userId])
- BFF 删除
password、处理手机号和头像 URL,然后写入缓存并返回。
当前 userId=1 的样例数据会得到 postCount=2,用户信息来自 SQL 里的 user 表。
3. RPC 注册、发现和调用原理
服务端流程:
- user/post 服务创建
ZookeeperRegistry,地址是127.0.0.1:2181。 - 创建
RpcServer,user 服务监听10000,post 服务监听20000。 - 连接 MySQL。
- 使用
server.addService暴露接口名和方法实现。 server.start()启动本地 RPC 服务。server.publish()把服务发布到 Zookeeper。
BFF 消费端流程:
- 创建同一个 Zookeeper 注册中心客户端。
- 根据接口名创建 consumer。
consumer.ready()从注册中心发现可用服务提供者。consumer.invoke(method, args)发起远程调用。- user/post 服务查询 MySQL 后把结果返回给 BFF。
这个机制的价值是:BFF 不需要硬编码 user/post 的具体地址,只需要知道接口名。但当前代码是在每次 HTTP 请求里创建 registry/client/consumer,适合演示,不适合生产。更合理的做法是应用启动时初始化一次并复用。
4. 多级缓存原理
CacheStore 是一个简单的缓存组合器:
get(key):按添加顺序查找 store,当前顺序是 MemoryStore -> RedisStore。set(key, value):把同一份数据写入所有 store。
设计意图:
- LRU 本地缓存:速度最快,适合同一进程内的热点数据。
- Redis 缓存:多个 BFF 实例共享,跨进程可用。
当前实现需要注意:
cacheMiddleware在每次请求里new MemoryStore(),所以 LRU 缓存不能跨请求复用,实际命中价值很低。RedisStore也在每次请求里创建新连接,会带来额外连接开销。- Redis 写入没有 TTL,缓存不会自动过期。
- Redis 命中后没有回填 MemoryStore,无法把二级缓存提升为一级缓存。
5. RabbitMQ 日志链路
日志链路的作用是解耦:
- BFF 只负责把日志消息投递到
logger队列。 write-logger作为独立进程消费队列,并追加写入logger.txt。- HTTP 响应不需要等待文件写入完成。
当前实现也有几个可靠性点:
assertQueue('logger')没有配置 durable,队列重启后可能丢。sendToQueue没有设置 persistent,消息重启后可能丢。consume默认需要手动 ack,但代码没有logger.ack(event),消息会保持 unacked 直到连接关闭。
6. gRPC demo 原理
grpcdemo/ 展示的是标准 gRPC 三件套:
hello.proto定义包名、服务名、方法名、请求结构和响应结构。server.js加载 proto,注册SayHello实现,绑定127.0.0.1:10086。client.js加载同一份 proto,创建 client,并调用SayHello({ name, age })。
它和 bff/ 的 sofa-rpc-node 主链路没有直接依赖关系,只是另一个 RPC 方案的入门示例。
7. 数据库模型
bff/bff/bff_2023-01-09.sql 里有两张表:
user:保存用户基础信息,示例用户是id=1、username=张三。post:保存文章,示例里user_id=1有两条文章。
BFF 的聚合结果来自两次 RPC 查询:
- 用户详情来自
user表。 - 文章数量来自
post表的count(*)。
8. 当前项目的关键改进点
- 把 RPC client、Redis client、RabbitMQ connection/channel、LRU cache 移到应用启动阶段初始化并复用。
- SQL 改成参数化查询,避免
userId字符串拼接带来的注入风险。 - 给
userId做类型校验和错误响应。 - Redis 增加 TTL,并在 Redis 命中时回填 LRU。
- RabbitMQ 增加 durable queue、persistent message、manual ack。
phone脱敏现在使用$1****$2,如果目标是保留后四位,应改为$1****$3。avatar拼成http://localhost:3000/avatar.jpg,但 BFF 当前没有静态资源中间件,图片地址可能无法访问。grpc包已经比较旧,新的 Node gRPC 项目通常使用@grpc/grpc-js。
RPC / BFF / RabbitMQ / Zookeeper 小白说明
这份文档专门解释这个项目里最容易绕的几个东西:
sofa-rpc-node是什么,服务端和客户端怎么配合- RabbitMQ / AMQP 是什么,为什么要用消息队列
- “服务注册与发现”是什么意思
- Zookeeper 在这里到底干了什么
- 一次请求从浏览器到 BFF、RPC、MySQL、RabbitMQ 的完整过程
先记一句话:
这个项目的 BFF 像一个前台接待员。前端只问 BFF,BFF 再去找 user 服务、post 服务、Redis、RabbitMQ,把结果整理好返回。
1. 先看整体
这个项目有几类角色:
- 浏览器 / 前端:只访问
http://localhost:3000/?userId=1。 - BFF:对前端提供 HTTP 接口,负责聚合数据。
- user RPC 服务:只负责查用户信息。
- post RPC 服务:只负责查文章数量。
- MySQL:保存用户和文章数据。
- Redis / LRU:缓存 BFF 聚合结果。
- RabbitMQ:接收访问日志消息。
- write-logger:消费日志消息,写入
logger.txt。 - Zookeeper:保存“有哪些 RPC 服务可用、它们在哪里”。
你可以把它想成:
前端:给我 userId=1 的页面数据
BFF:我去问 user 服务拿用户信息,再问 post 服务拿文章数
Zookeeper:user 服务在 172.x.x.x:10000,post 服务在 172.x.x.x:20000
RabbitMQ:日志先放我这里,慢慢写文件
2. BFF 是什么
BFF 全称是 Backend For Frontend,意思是“专门服务前端的后端层”。
如果没有 BFF,前端可能要自己请求很多接口:
前端 -> 用户服务
前端 -> 文章服务
前端 -> 其他服务
有了 BFF 后,前端只请求一个接口:
前端 -> BFF -> 用户服务
          |
          -> 文章服务
这个项目里,BFF 的入口是 bff/bff/index.js。
核心代码是:
const [userInfo, postCount] = await Promise.all([
    user.invoke('getUserInfo', [userId]),
    post.invoke('getPostCount', [userId]),
]);
这段代码的意思是:BFF 同时远程调用 user 服务和 post 服务,然后把结果合并。
3. RPC 是什么
RPC 全称是 Remote Procedure Call,翻译成中文是“远程过程调用”。
普通函数调用是:
同一个进程里:
getUserInfo(1)
RPC 的感觉是:
BFF 进程里写:
user.invoke('getUserInfo', [1])

实际执行在另一个 user 服务进程里。
所以 RPC 给人的感觉像“调用本地函数”,但真正发生的是网络请求。
4. sofa-rpc-node 在项目里怎么用
sofa-rpc-node 是这个项目使用的 RPC 框架。它帮你做两件事:
- 服务端:把一个 JS 方法发布成 RPC 服务。
- 客户端:根据接口名找到服务并调用方法。
4.1 服务端怎么写
user 服务在 bff/user/index.js。
关键步骤:
const registry = new ZookeeperRegistry({ address: 'zookeeper:2181' });
const server = new RpcServer({ registry, port: 10000 });

server.addService(
    { interfaceName: 'com.keen.user' },
    {
        async getUserInfo(userId) {
            // 查 MySQL
        }
    }
);

await server.start();
await server.publish();
重点理解:
ZookeeperRegistry:告诉 RPC 框架注册中心在哪里。RpcServer:创建一个 RPC 服务端。addService:声明“我提供一个叫com.keen.user的服务”。getUserInfo:这个服务里可以远程调用的方法。start:启动服务端端口。publish:把服务地址发布到 Zookeeper,让别人找得到。
post 服务同理,只是接口名是 com.keen.post,端口是 20000。
4.2 客户端怎么写
BFF 里的 RPC 客户端在 bff/bff/middlewares/rpc.js。
关键步骤:
const registry = new ZookeeperRegistry({ address: 'zookeeper:2181' });
const client = new RpcClient({ registry });

const consumer = client.createConsumer({
    interfaceName: 'com.keen.user'
});

await consumer.ready();
const userInfo = await consumer.invoke('getUserInfo', [userId]);
重点理解:
RpcClient:创建 RPC 客户端。createConsumer:创建某个接口的消费者。interfaceName:必须和服务端addService里的名字一致。consumer.ready():等待从 Zookeeper 找到服务提供者。consumer.invoke(method, args):真正发起远程调用。
一句话记忆:
服务端:addService -> start -> publish
客户端:createConsumer -> ready -> invoke
5. 服务注册与发现是什么
服务注册与发现,就是为了解决一个问题:
BFF 怎么知道 user 服务在哪里?
最笨的方法是把地址写死:
const userService = 'http://127.0.0.1:10000';但微服务环境里,服务可能有多个实例,也可能重启换 IP:
user-1: 172.25.0.8:10000
user-2: 172.25.0.9:10000
post-1: 172.25.0.7:20000
所以需要一个“通讯录”:
流程是:
- user 服务启动。
- user 服务把自己注册到 Zookeeper。
- post 服务启动。
- post 服务把自己注册到 Zookeeper。
- BFF 想调用
com.keen.user。 - BFF 去 Zookeeper 查这个服务有哪些地址。
- BFF 拿到地址后发起 RPC 调用。
这里的“注册中心”就是 Zookeeper。
6. Zookeeper 是什么
Zookeeper 可以先理解成一个“分布式通讯录 + 监听器”。
它常用于:
- 服务注册与发现
- 分布式锁
- 配置管理
- 集群协调
这个项目里只用到了 服务注册与发现。
它大概像一个目录树:
/sofa-rpc
  /com.keen.user
    /provider-172.25.0.8:10000
  /com.keen.post
    /provider-172.25.0.7:20000
服务启动时:
user 服务:我叫 com.keen.user,我的地址是 172.25.0.8:10000
Zookeeper:好的,我记下来
BFF 调用时:
BFF:我要找 com.keen.user
Zookeeper:它现在在 172.25.0.8:10000
Zookeeper 还有一个重要能力叫 临时节点:
- 服务活着,节点存在。
- 服务挂了,连接断开,节点会消失。
- 消费者可以收到变化通知,知道服务下线了。
所以它不只是一本静态通讯录,更像一本会自动更新的通讯录。
7. RabbitMQ / AMQP 是什么
RabbitMQ 是消息队列服务器。
AMQP 是 RabbitMQ 使用的一种消息协议。你可以先粗略理解成:
AMQP 规定了“消息怎么发、发到哪、队列怎么收、消费者怎么确认”。
几个关键词:
- Producer:生产者,负责发消息。这个项目里是 BFF。
- Broker:消息服务器,RabbitMQ 就是 Broker。
- Exchange:交换机,负责根据规则分发消息。
- Queue:队列,真正存放消息的地方。
- Consumer:消费者,负责取消息处理。这个项目里是
write-logger。 - Ack:确认,消费者处理完消息后告诉 RabbitMQ“这条我处理好了”。
这个项目写得很简单,BFF 没有显式创建 exchange,而是使用了 RabbitMQ 的默认 exchange:
channel.sendToQueue('logger', Buffer.from('...'));sendToQueue(queueName, content) 可以理解成:
把消息直接发到名为 logger 的队列里8. amqplib 在项目里怎么用
8.1 BFF 发送日志
发送端在 bff/bff/middlewares/mq.js 和 bff/bff/index.js。
关键步骤:
const mqClient = await amqplib.connect('amqp://...');
const channel = await mqClient.createChannel();
await channel.assertQueue('logger');
channel.sendToQueue('logger', Buffer.from(JSON.stringify(log)));
解释:
connect:连接 RabbitMQ。createChannel:创建通道,后续发消息都通过 channel。assertQueue:确保队列存在。sendToQueue:发送消息到队列。
8.2 write-logger 消费日志
消费端在 bff/write-logger/index.js。
关键步骤:
const mqClient = await amqplib.connect('amqp://...');
const channel = await mqClient.createChannel();
await channel.assertQueue('logger');

channel.consume('logger', async (event) => {
    await fs.appendFile('./logger.txt', event.content.toString() + '\n');
    channel.ack(event);
});
解释:
consume:订阅队列,队列有消息就执行回调。event.content:消息内容,是 Buffer。ack:告诉 RabbitMQ 这条消息处理成功,可以删除。
为什么要用消息队列?
如果 BFF 直接写文件:
HTTP 请求 -> 写 logger.txt -> 再返回响应文件写入慢时,请求也会变慢。
用了 RabbitMQ 后:
HTTP 请求 -> 把日志扔进队列 -> 继续返回响应
write-logger 慢慢消费队列 -> 写 logger.txt
这叫 异步解耦。
9. 一次请求完整发生了什么
当你访问:
curl 'http://localhost:3000/?userId=1'完整流程是:
- 浏览器 / curl 请求 BFF。
- BFF 把访问日志发到 RabbitMQ。
- BFF 生成缓存 key:
GET-/-1。 - BFF 先查 LRU,再查 Redis。
- 缓存没命中,BFF 从
ctx.rpcConsumers取出user和postconsumer。 - BFF 调用
user.invoke('getUserInfo', [1])。 - BFF 调用
post.invoke('getPostCount', [1])。 - user/post 服务各自查 MySQL。
- BFF 删除密码、处理手机号和头像。
- BFF 写缓存。
- BFF 返回 JSON。
- write-logger 从 RabbitMQ 消费日志并写入文件。
10. 这几个东西的关系
最容易混的地方是:
- Zookeeper 不传业务数据,它只是告诉 BFF 服务在哪里。
- RabbitMQ 不负责 RPC 调用,它只负责暂存和投递消息。
- sofa-rpc-node 负责远程调用,但它需要 Zookeeper 帮它找服务地址。
- BFF 是 HTTP 入口,前端不会直接接触 user/post RPC 服务。
11. 小白记忆版
BFF:前台,接前端请求,拼数据。
user/post:后厨,各做一道菜。
sofa-rpc-node:前台和后厨之间的内部电话。
Zookeeper:电话簿,记录每个后厨的电话号码。
RabbitMQ:留言箱,日志先丢进去。
write-logger:专门看留言箱并抄到本子上的人。
Redis/LRU:备忘录,之前查过的结果先记下来。
对应到代码:
发布 RPC 服务:server.addService -> server.start -> server.publish
调用 RPC 服务:client.createConsumer -> consumer.ready -> consumer.invoke

发送 MQ 消息:connect -> createChannel -> assertQueue -> sendToQueue
消费 MQ 消息:connect -> createChannel -> assertQueue -> consume -> ack
12. 当前 demo 里要注意的点
这个项目是学习 demo,不是生产级写法:
- RPC consumer、Redis client、RabbitMQ channel 现在仍然是在请求链路里创建,生产中应该启动时创建并复用。
- RabbitMQ 队列没有设置 durable,消息没有设置 persistent,重启后可能丢。
- Redis 缓存没有 TTL,可能一直不过期。
- gRPC demo 使用的是老包
grpc,新项目一般用@grpc/grpc-js。
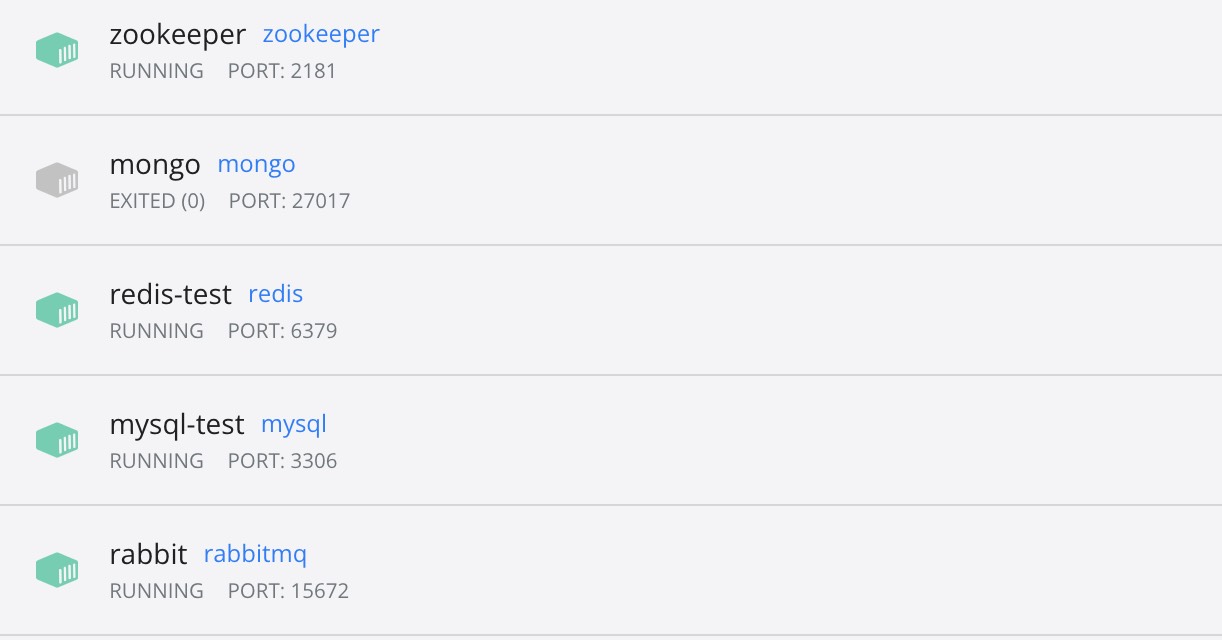
前置准备,如果不在本机安装mysql这些,就使用docker
1.安装docker
2.docker安装redis镜像
3.docker安装mysql镜像 sql表信息:https://github.com/fengnovo/rpc-bff/blob/main/bff/bff/bff_2023-01-09.sql
4.docker安装zookeeper镜像
5.docker安装rabbitmq镜像
docker安装和启动zookeeper
参考 https://betheme.net/qianduan/36331.html?action=onClick
docker run --name zookeeper -d -p 2181:2181 zookeeper
docker安装和启动
参考 https://blog.csdn.net/qq_45502336/article/details/118699251
docker run -d --hostname my-rabbit --name rabbit -p 15672:15672 -p 5672:5672 rabbitmq
启动
// 启动user微服务
cd /bff/user
npm install
npm run dev
// 启动post微服务
cd /bff/post
npm install
npm run dev// 启动web的bff层
cd /bff/bff
npm install
npm run dev// 启动消息队列
cd /bff/write-logger
npm install
npm run dev